지침도 검증 대상이다 — 대회 규정을 Claude Code 스킬 5개로 만든 해커톤 회고
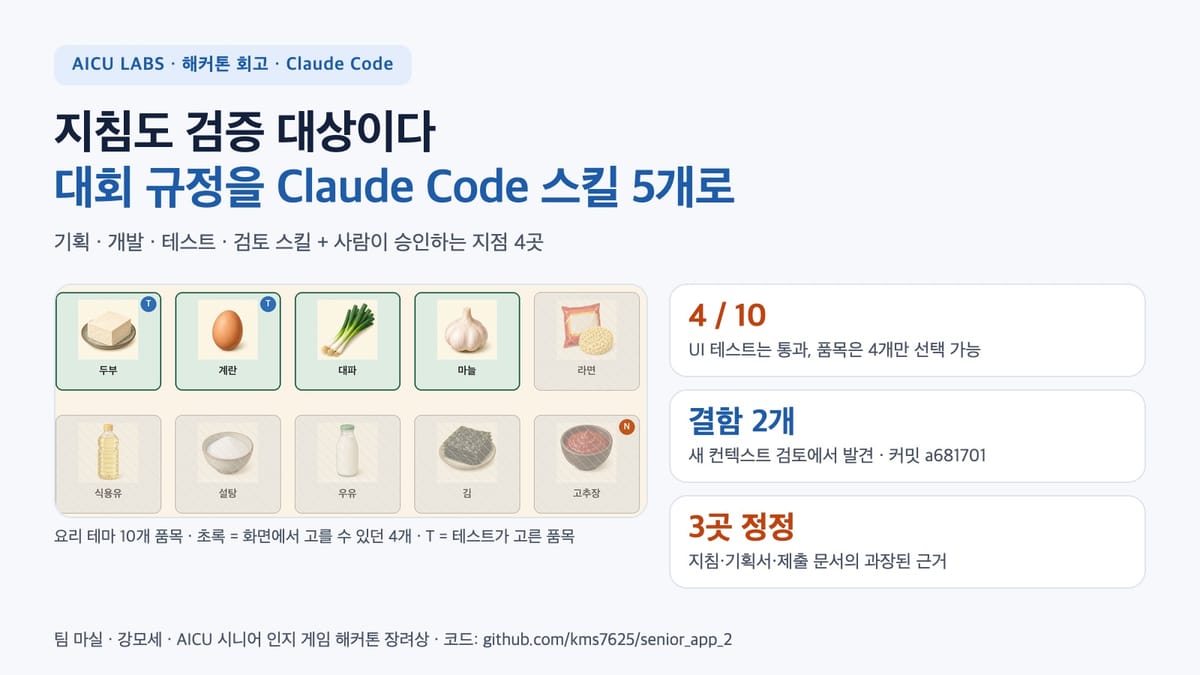
대회 규정을 Claude Code 스킬 5개로 만들어 쓴 해커톤 회고. 테스트를 통과한 앱의 결함 2개와, 지침에 남은 과장된 근거를 정정한 이야기.
팀 마실 · 강모세 (영진전문대학교 컴퓨터정보공학과)
AICU 시니어 인지기능 향상 게임 개발 해커톤 장려상작 ‘우리 집에 놀러와’ 두 번째 이야기
TL;DR
- 해커톤 규정(외부 AI 금지, 감점 기준, 제출 문서 요건)을 Claude Code의 작업 지침(스킬) 5개로 만들어 기획·개발·테스트·검토 단계마다 불러 쓰게 했습니다. 개인 설정 저장소에서 다듬어 온 규칙(“완료 = 검증 명령 통과”, 독립 검증)을 이 프로젝트에 맞게 옮겼습니다.
- 지침을 적용한 검토에서, 자동화 테스트를 통과한 앱의 결함 두 개를 찾았습니다.
- 그런데 블로그를 쓰며 원문과 대조해 보니 지침 자체에 과장된 근거가 있었고 같은 과장된 주장이 기획서와 제출 문서에도 남아 있었습니다. 세 문서를 정정하고 근거를 적는 규칙을 지침에 추가했습니다. 그래서 이 글의 결론은 ‘지침도 검증 대상이다’입니다.
1. 테스트를 통과한 앱에서 결함 두 개가 나왔다
첫 번째 글에서 소개한 ‘우리 집에 놀러와’는 Android 태블릿용 시니어 인지 게임입니다. 첫 플레이 가능한 빌드가 돌아가던 시점, 빌드와 자동화 UI 테스트가 모두 통과하는 상태에서 개발 대화를 이어받지 않은 새 컨텍스트의 AI 서브에이전트에 코드베이스 검토를 맡겼습니다. 대회 규정 점검과 일반 코드 품질 검토를 함께 요청했습니다. 그 결과 기능 결함 두 개가 나왔습니다. 규정 점검 쪽에서는 오픈소스 라이선스 목록 문서가 빠져 있다는 지적이 나와 docs/licenses.md를 추가했습니다. 제출 요건을 기준으로 한 지적이었습니다.
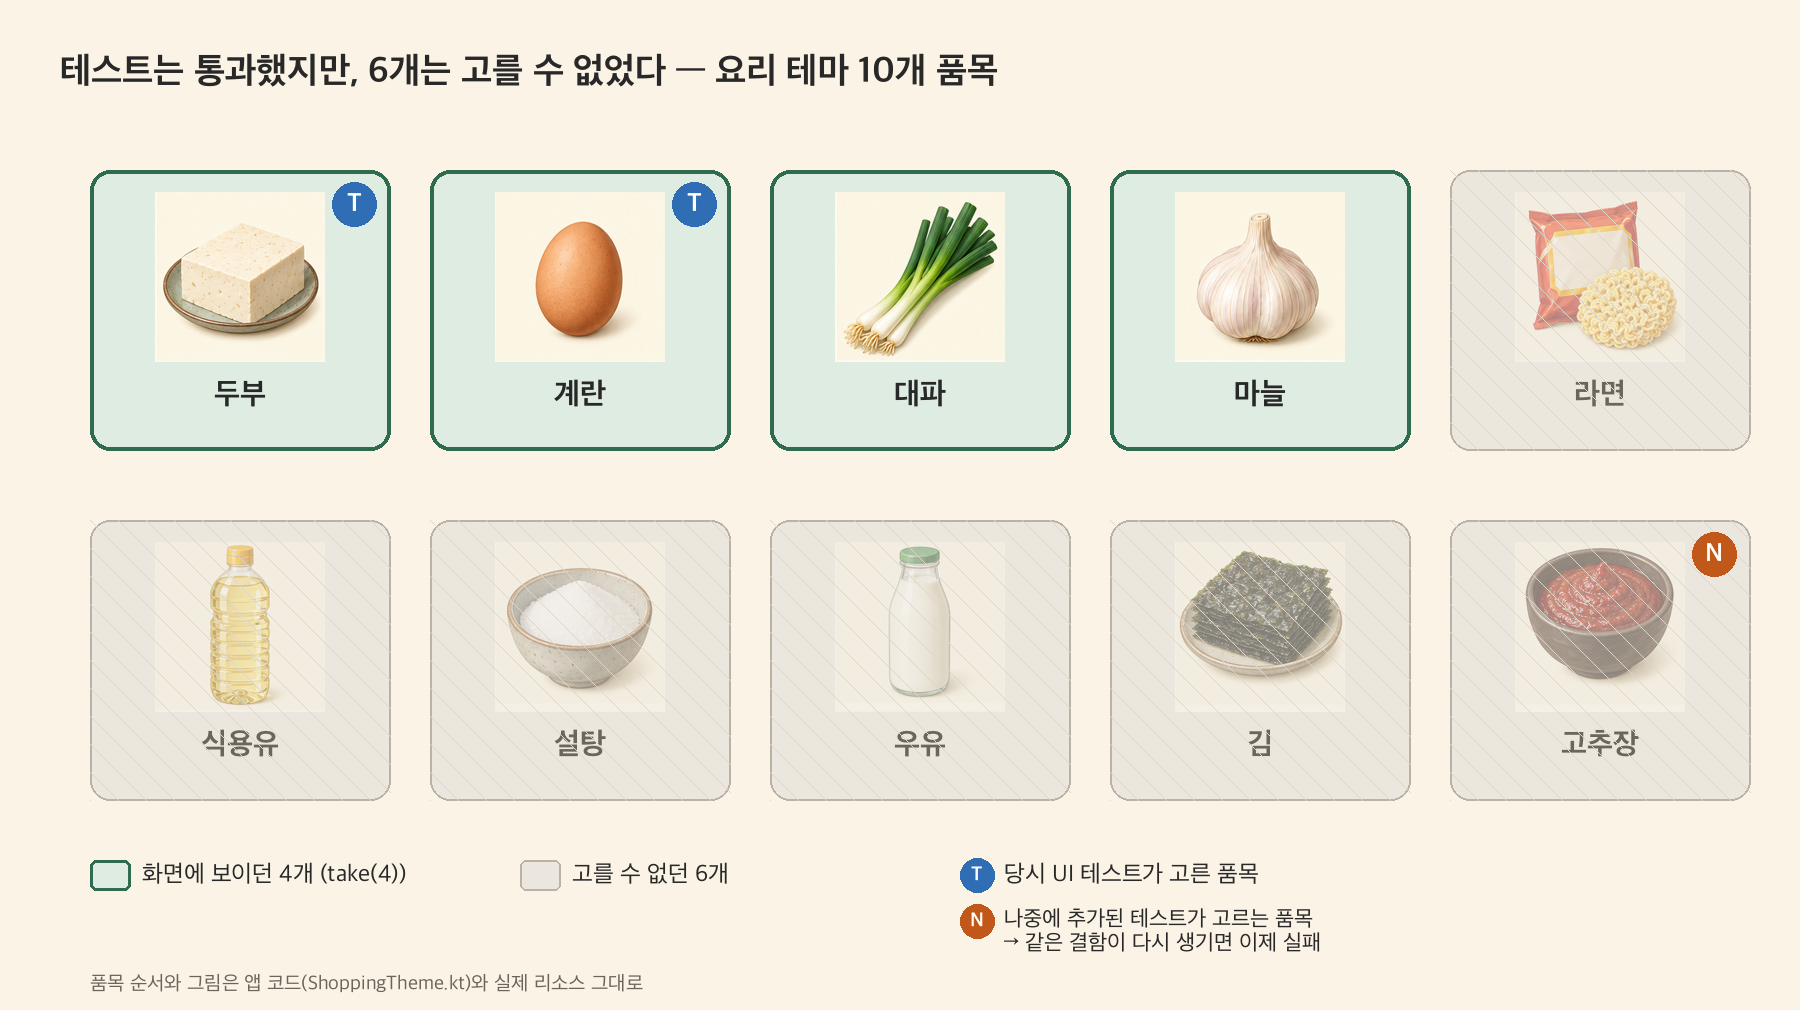
- 계획 화면에서 테마당 10개 품목 중 앞의 4개만 고를 수 있었습니다(
theme.items.take(4)). - 설정 화면의 토글 3개는 화면 안에만 값을 갖고 있어서 눌러도 게임이 바뀌지 않았습니다.
테스트가 이 결함을 놓친 이유는 단순했습니다. UI 테스트는 ‘두부’와 ‘계란’을 골라 한 판을 끝까지 진행하는지만 확인했습니다. 두 품목은 앞의 4개 안에 있었고, 설정은 건드리지 않았습니다. 테스트는 통과했지만 “플레이어가 준비물을 직접 고른다”는 기획 의도는 확인하지 않고 있었습니다.
이 리뷰에서는 이 글의 주제인 작업 지침을 검토 기준으로 활용했습니다. 다만 이번 리뷰는 규정 점검과 일반 코드 리뷰를 합쳐 진행했기 때문에 결함 발견이 스킬만의 효과라고 분리해 말할 수는 없습니다. 제가 말할 수 있는 것은 “독립 검토를 언제, 무엇을 기준으로 할지 반복 가능한 절차로 만들어 두었고, 그 절차에서 결함을 찾았다”까지입니다.
2. 대회 규정을 작업 조건으로 바꾸는 법
스킬 파일은 Claude Code가 작성했습니다. 제가 설계한 것은 스킬을 만들게 하는 지시서입니다. 지시서에는 설계 원칙, 완료 기준, 그리고 멈춤 조건(이름 충돌, 검증 명령을 정할 수 없을 때, 규정 해석이 애매할 때는 AI가 임의로 정하지 말고 사람에게 묻기)을 넣었습니다.
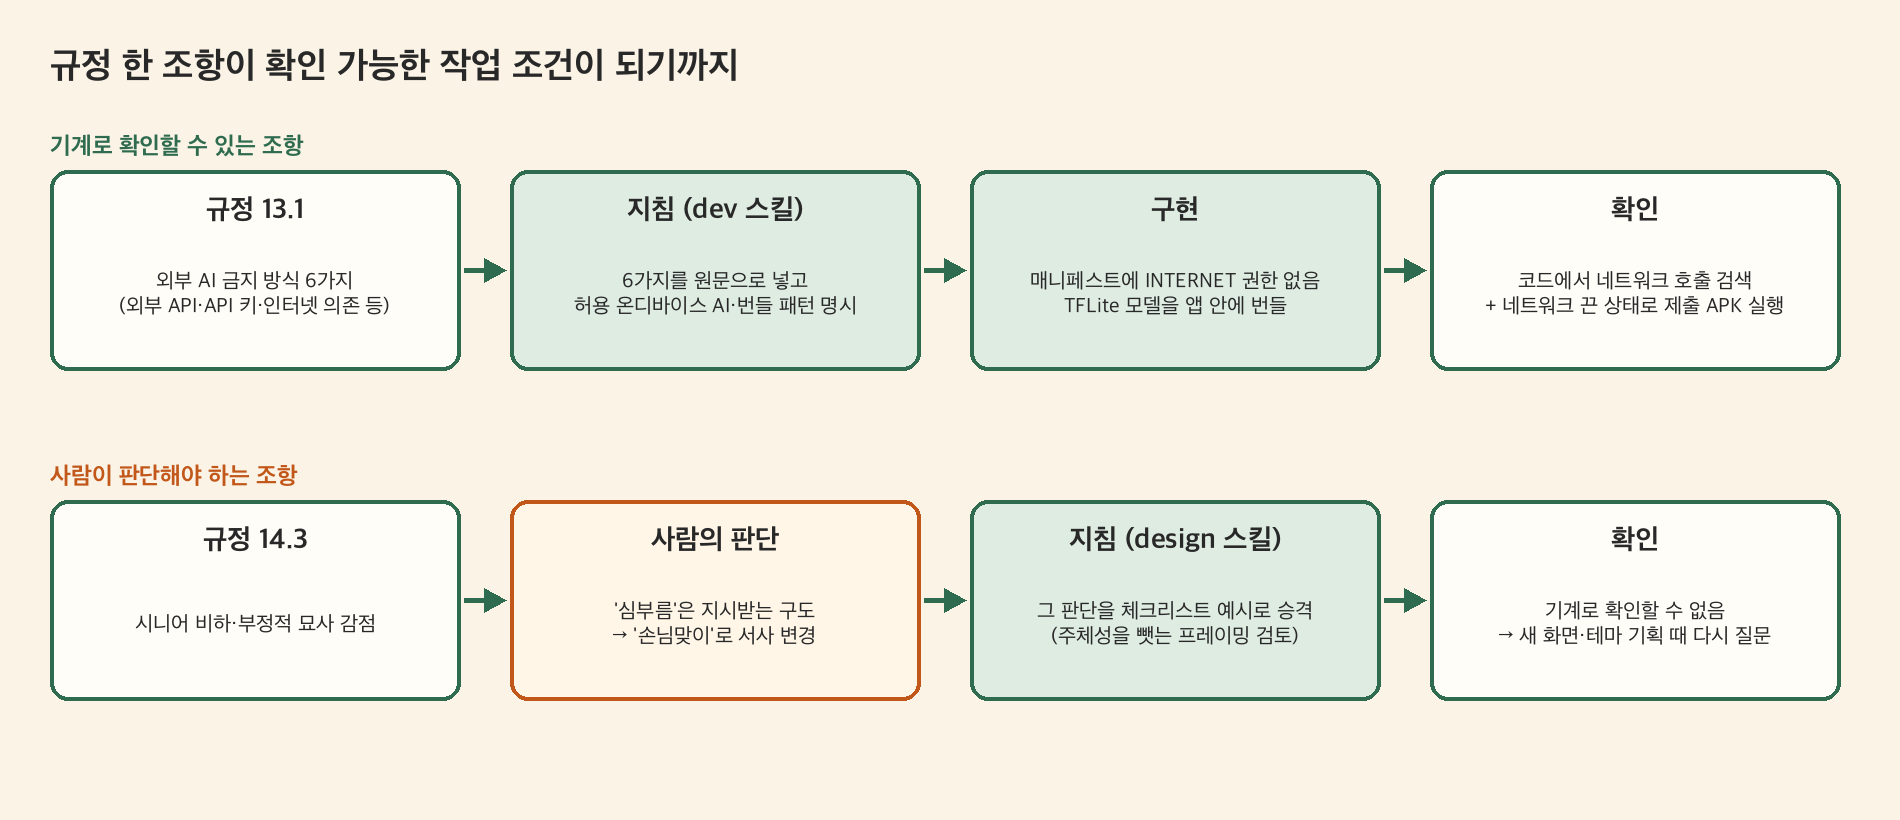
핵심 원칙은 “규정은 조항 번호와 원문으로 연결하고, ‘적절히 확인’ 같은 재량 표현을 쓰지 않는다”였습니다. 한 조항이 실제 작업 조건이 되는 과정은 이렇습니다.
외부 AI 금지(기획안 13.1): 여기서 금지하는 것은 완성된 앱이 외부 AI 서비스와 통신하는 방식입니다. 개발 과정에서 AI 코딩 도구를 쓰는 것은 대회가 허용했습니다.
- 규정: 금지 방식 6가지. 외부 생성형 AI API 호출, API 키로 외부 AI에 연결, 인터넷이 없으면 AI가 동작하지 않는 구조 등입니다. - 지침: 개발 스킬에 6가지를 원문으로 넣고 허용되는 온디바이스 AI(TFLite 등)와 “모델은 앱에 번들해 기기 안에서만 추론” 패턴을 적었습니다.
- 구현 조건: 앱 매니페스트에 INTERNET 권한을 두지 않았습니다. - 확인 방법: 코드 검색으로 네트워크 호출이 없는지 확인한 뒤 Wi-Fi와 모바일 데이터를 끈 에뮬레이터에서 제출용 APK를 처음부터 끝까지 실행했습니다.
시니어 비하 묘사 감점(기획안 14.3) - 이 조항은 기계적으로 확인할 수 없습니다. 기획 단계에서 저는 “누가 시켜서 하는 일”인 ‘심부름’ 서사가 이 조항에 걸릴 수 있다고 보고 플레이어가 준비물을 정하는 ‘손님맞이’로 바꿨습니다. - 스킬을 만들 때 이 사람의 판단을 체크리스트의 예시로 승격했습니다. 새 화면이나 테마를 기획할 때도 같은 질문이 다시 나오게 하기 위해서입니다.
솔직히 말하면, 완성된 스킬이 모두 원문 인용으로만 이뤄진 것은 아닙니다. 체크리스트에는 원문, 요약, 팀의 해석이 섞였는데 셋을 표시로 구분하지 못한 곳이 있습니다.
3. 스킬 5개와 사람이 결정하는 네 지점
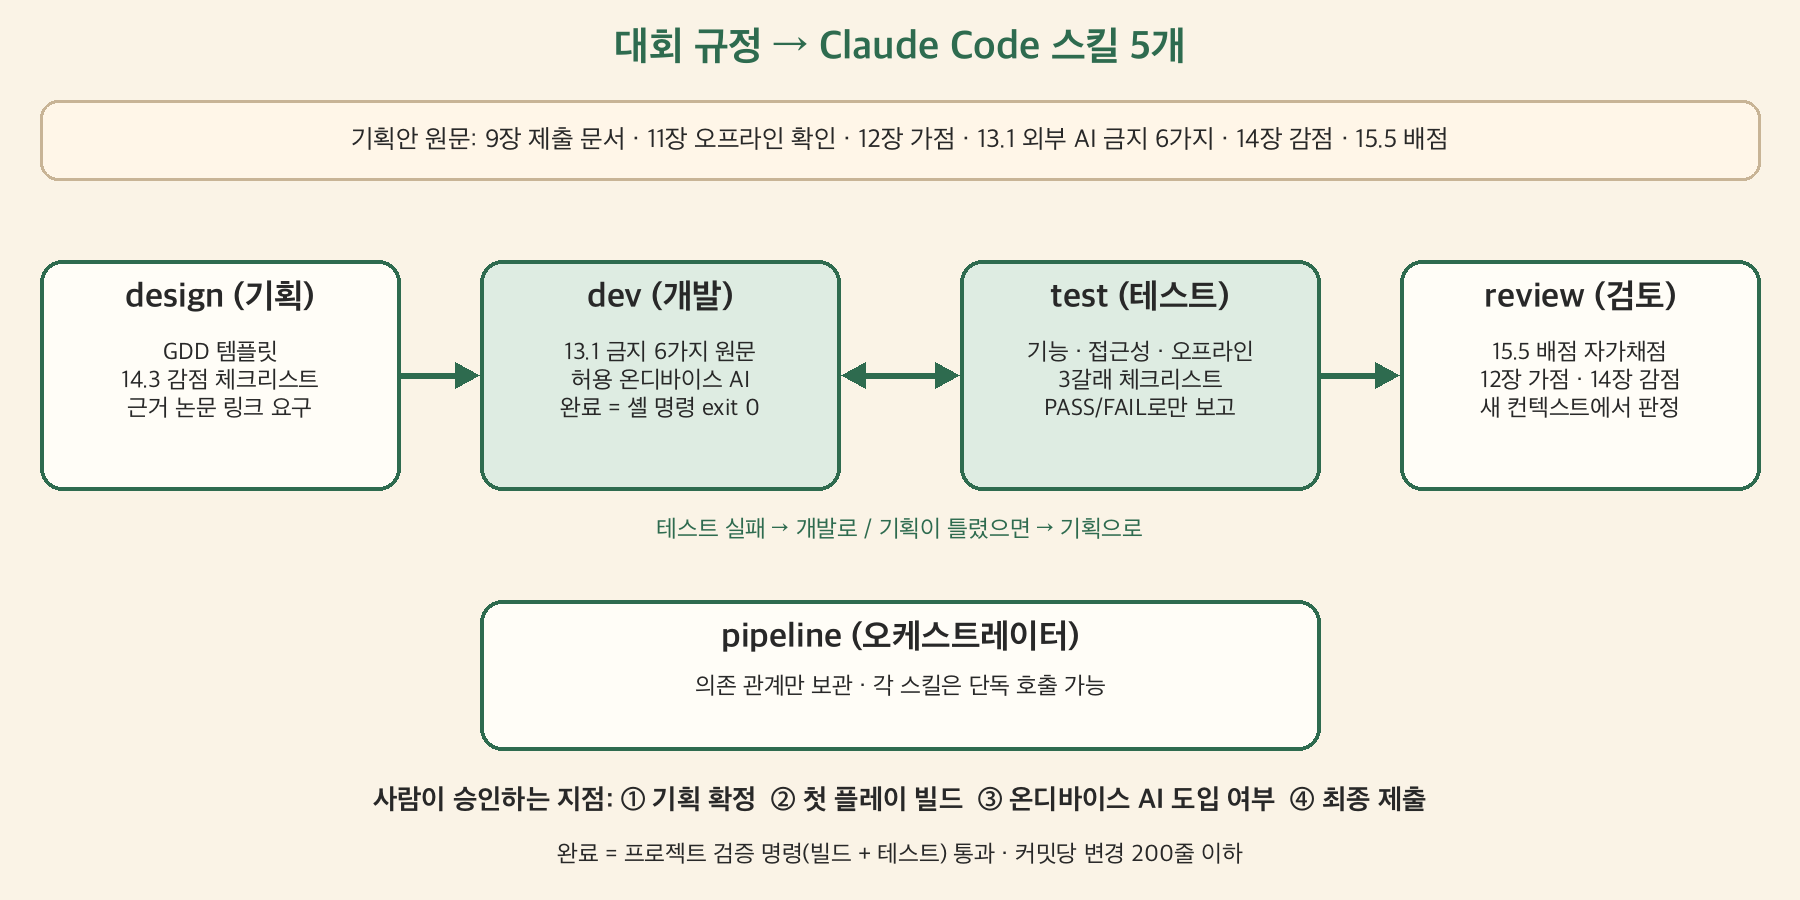
- design (기획): 대회 기획 문서 항목과 1:1로 대응하는 GDD 템플릿, 14.3 감점 체크리스트, 게임 규칙마다 근거 논문이나 가이드라인 링크를 요구하는 규칙
- dev (개발): 13.1 금지 6가지, 허용 온디바이스 AI, 시니어 UI 수치 기준. 완료 기준은 “
./gradlew assembleDebugexit 0” 같은 셸 명령이나 파일:행 단위로 확인할 수 있게 쓰고 “잘 보인다” 같은 형용사는 금지 - test (테스트): 2인 팀과 대회 요구에 맞춰 기능·접근성·오프라인 세 축으로 구성한 체크리스트. 셋 다 감점 사유와 직결되는 축입니다. 결과는 PASS/FAIL로만 보고
- review (검토): 배점표 자가채점, 가점·감점 조항 확인, 제출 문서 점검. 원칙은 “작성자는 자기 숙제를 채점할 수 없다”
- pipeline (오케스트레이터): 기획 → 개발 ⇄ 테스트 → 검토의 의존 관계와 사람이 승인하는 지점, 반복·위임 규칙을 보관. 각 스킬은 단독으로도 호출 가능
사람이 승인하는 지점은 일부러 남겼습니다. 기획 확정, 첫 플레이 빌드, 온디바이스 AI 도입 여부, 최종 제출입니다. 팀 역할도 스킬에 맞춰 나눴습니다. 저는 기획·개발을, 조영현 팀원은 개발·테스트·검토를 맡았습니다. 검토는 가능하면 그 기능을 구현하지 않은 쪽이 하도록 했습니다.
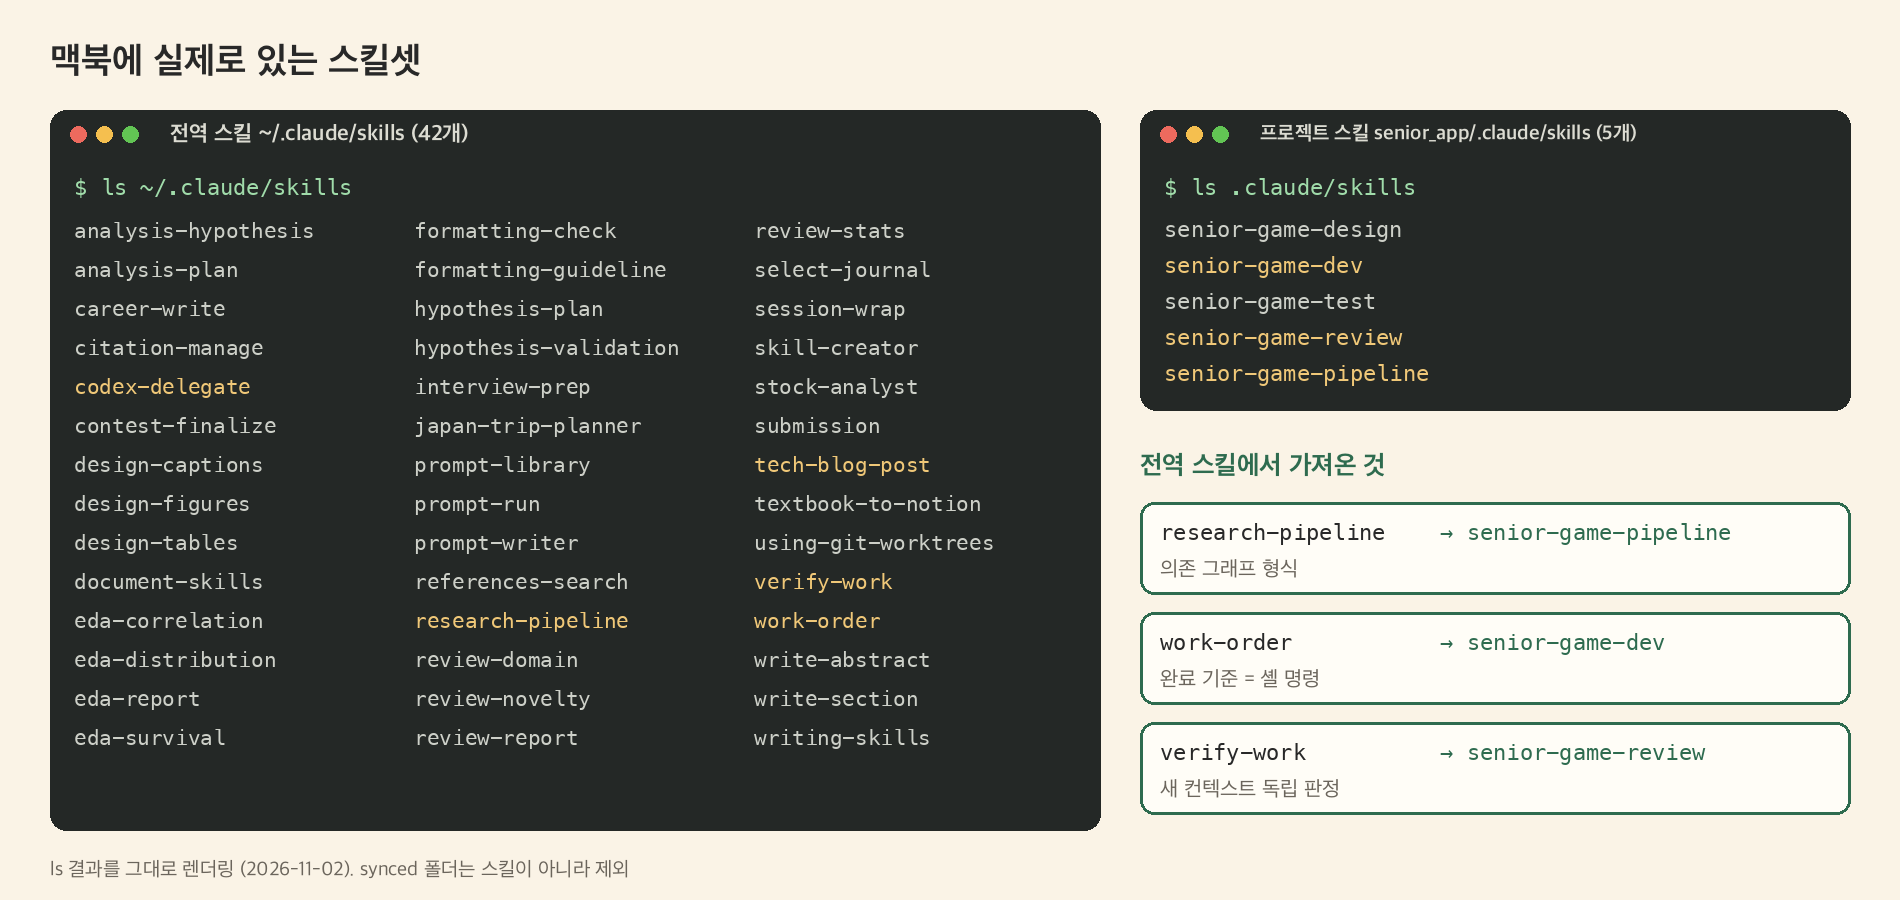
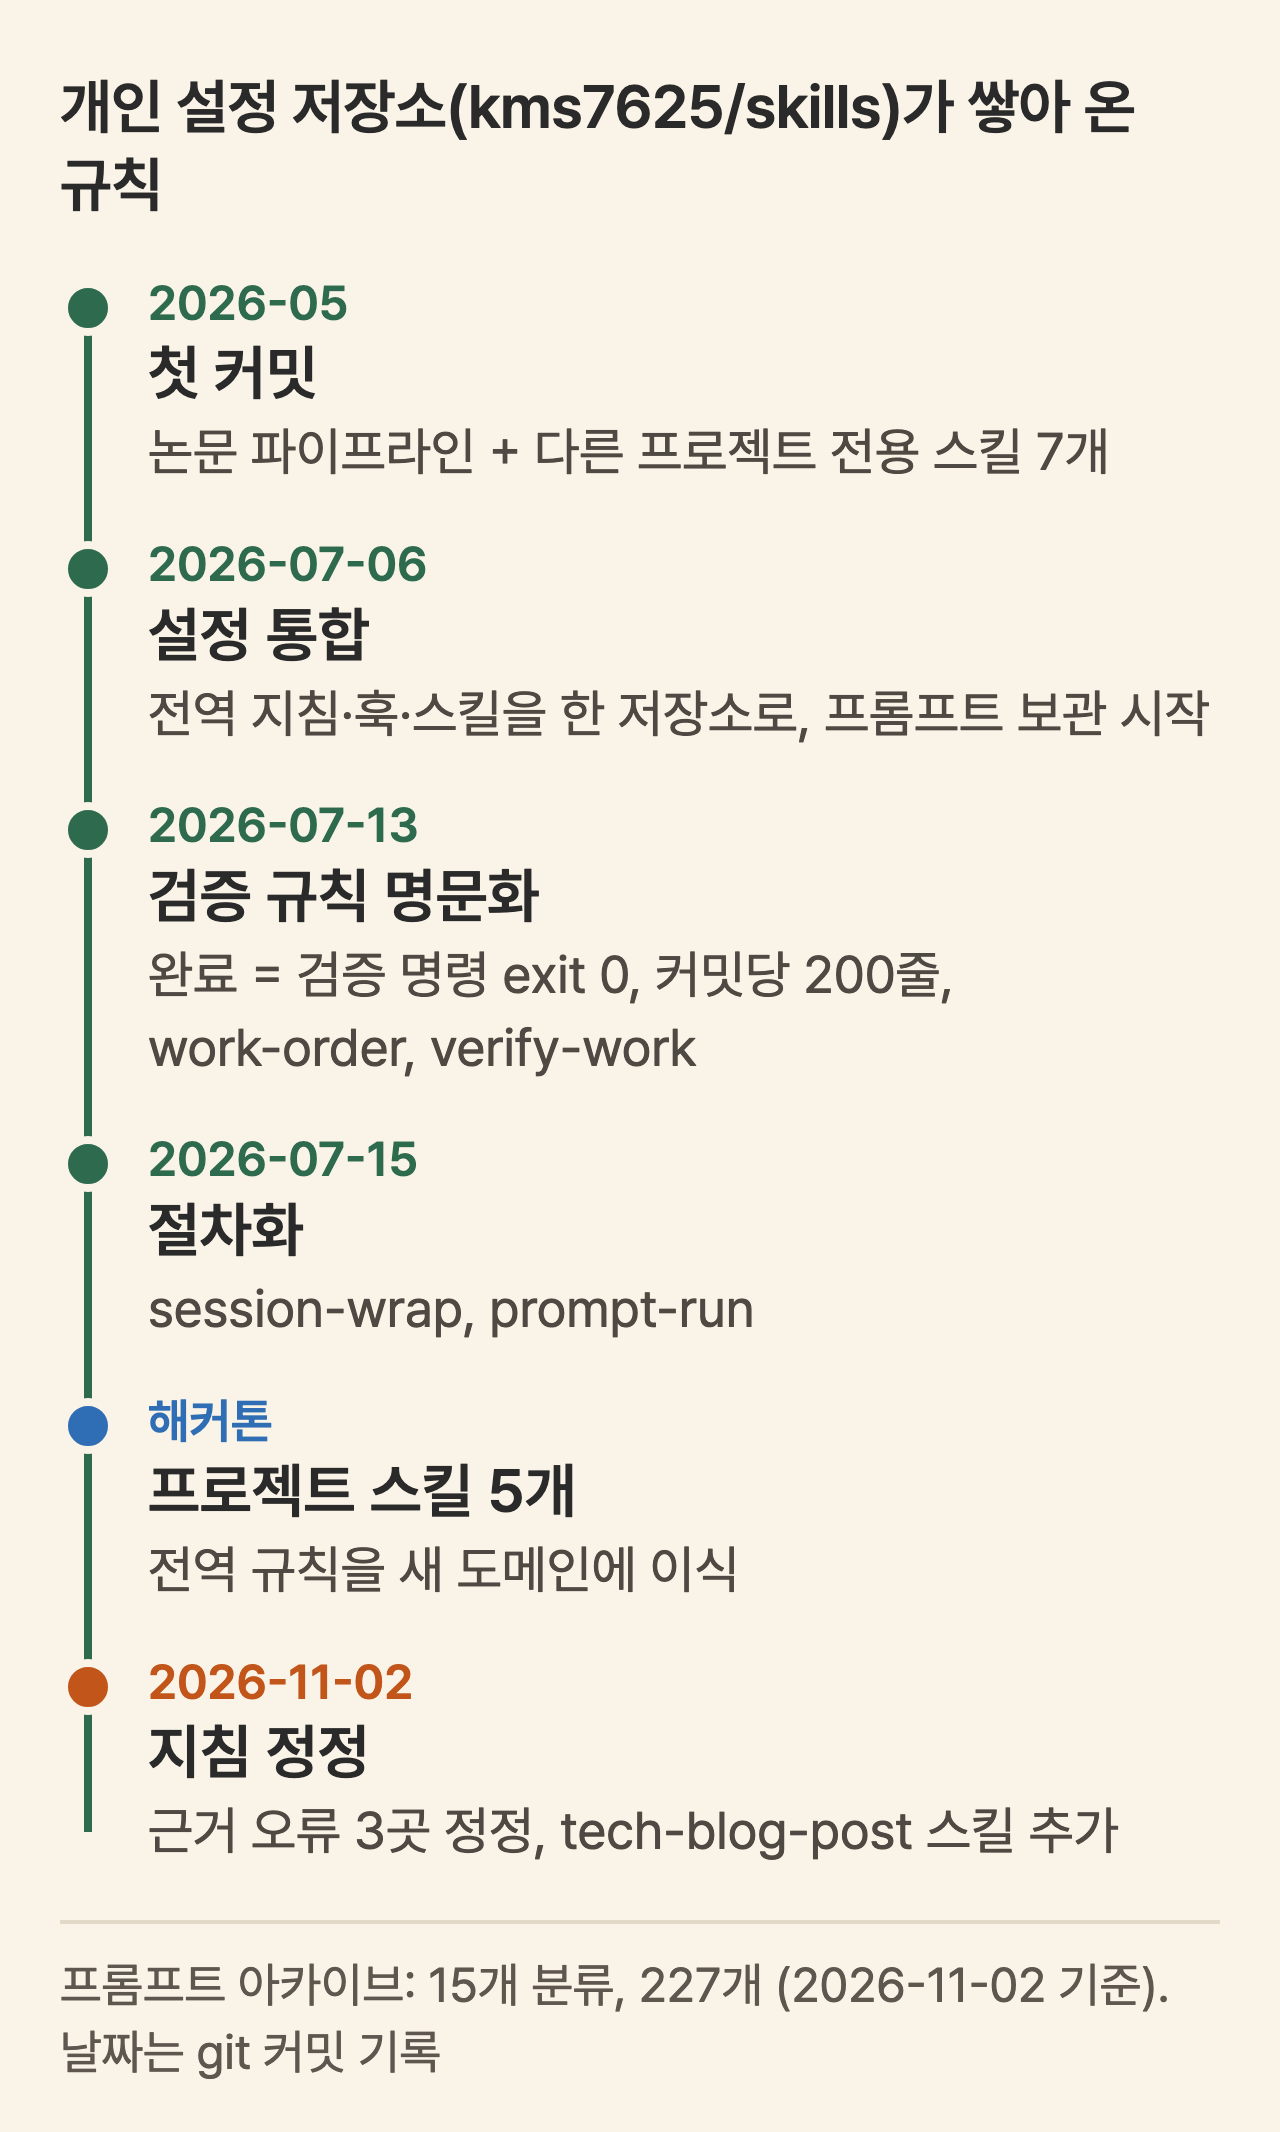
이 구조는 어디서 왔나. 저는 Claude Code의 전역 지침, 훅, 스킬을 개인 git 저장소 하나로 관리합니다. 그 저장소에는 이미 논문 작업용 파이프라인과 다른 프로젝트 전용 스킬이 있었습니다. 7월에는 전역 지침에 “완료 = 검증 명령 exit 0”과 “커밋당 변경 200줄 상한”을 명문화하고, 작업 지시서(work-order)와 독립 검증(verify-work) 스킬을 추가했습니다. 완성된 프롬프트도 같은 저장소에 보관하고 있으며, 타임라인 그림을 만들 때 기준으로 15개 분류에 227개가 쌓여 있었습니다. 시니어 게임용 스킬 5개는 이 규칙을 새 도메인에 옮겨 만들었습니다. 오케스트레이터는 연구 파이프라인의 의존 그래프를, 개발 스킬은 작업 지시서의 완료 기준을, 검토 스킬은 독립 검증 방식을 가져왔습니다.
4. 지킨 것과 지키지 못한 것
지침을 적어 두는 것과 그 지침이 지켜지는 것은 다른 문제였습니다. 저장소 이력이 그 차이를 그대로 보여줍니다.
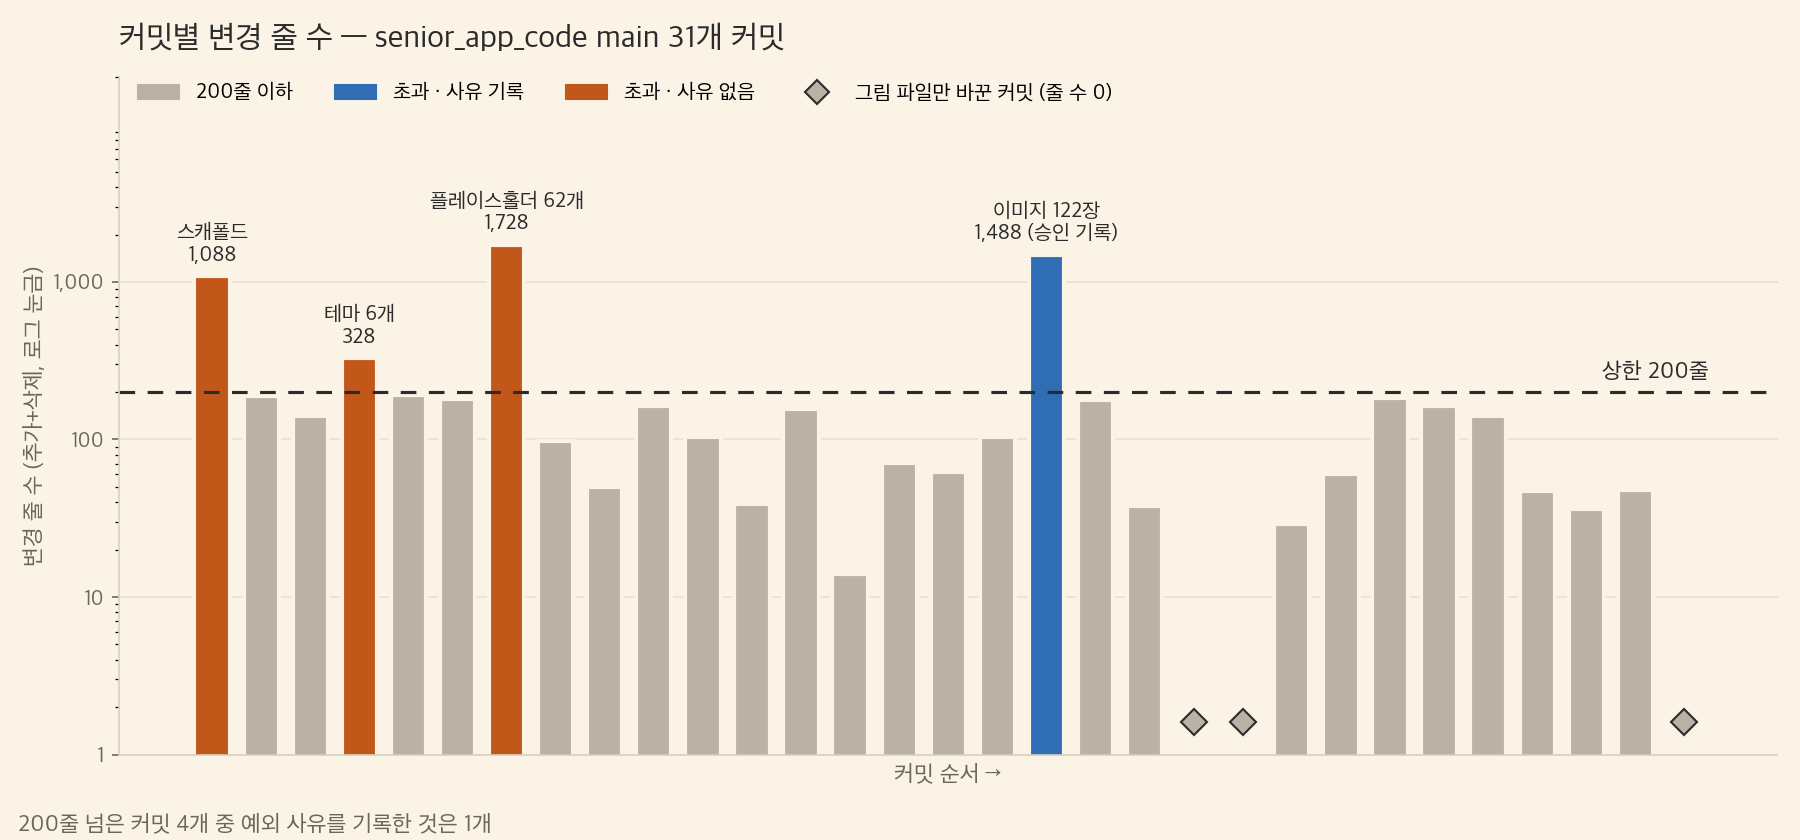
- 커밋당 200줄 상한: 코드 저장소의 커밋 31개 중 4개가 상한을 넘었습니다. 생성 이미지 122장으로 교체한 커밋만 “기계적 교체라 상한 초과를 승인받았다”는 사유를 본문에 남겼습니다. 초기 스캐폴드(1,088줄), 플레이스홀더 62개 추가(1,728줄), 테마 6개 코드화(328줄)에는 예외 사유가 기록돼 있지 않습니다.
- 접근성 기준은 한 곳에서 관리한다: 설계 원칙이었지만 실제로는 48dp·22pt 같은 수치가 개발 스킬과 테스트 스킬에 따로 적혔고 표현도 달랐습니다(“22pt 권장” / “22pt 이상이거나 그에 준하는 가독성”). 한쪽을 고치면 다른 쪽이 남는 구조였습니다.
- 회귀 테스트: 1절의 두 결함은 고친 뒤(수정 커밋 a681701) 테스트를 다시 통과시켰고 설정 쪽에는 단위 테스트를 추가했습니다. 이후 추가한 ‘이전 단계로 돌아가기’ UI 테스트가 목록 뒤쪽의 ‘고추장’을 고르기 때문에 앞 4개만 보이는 결함이 다시 생기면 이제는 테스트가 실패합니다. 다만 이것은 의도한 검증이 아니라 우연히 생긴 보호입니다. 모든 테마의 10개 품목을 각각 고를 수 있는지 확인하는 테스트는 아직 없습니다.
5. 세 문서에 남은 잘못된 근거, 그리고 정정
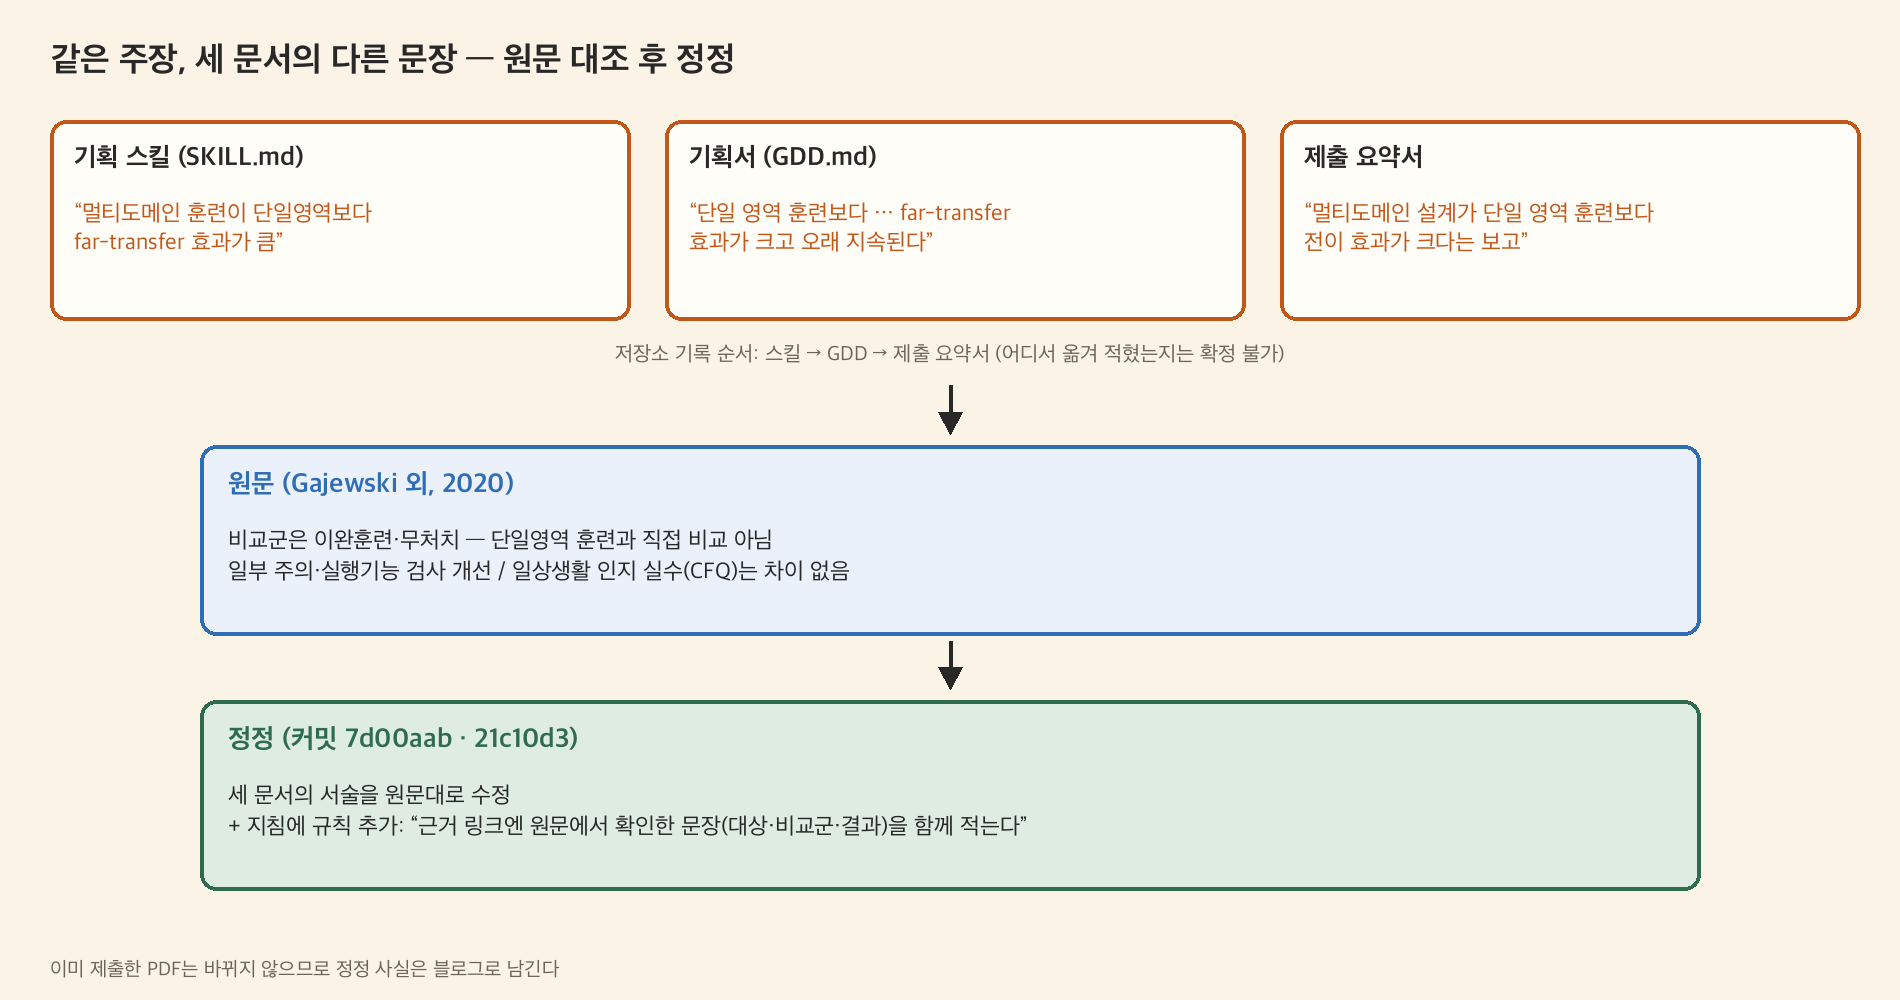
첫 번째 글을 쓰며 참고 논문을 원문과 하나씩 대조했습니다. 기획 스킬에는 이렇게 적혀 있었습니다.
멀티도메인 훈련이 단일영역보다 far-transfer 효과가 큼 (Gajewski 외, 2020)
원문은 달랐습니다. 이 연구는 다영역 훈련을 이완훈련 및 무처치 조건과 비교했습니다. 일부 주의·실행기능 검사에서는 개선이 관찰됐지만 일상생활의 인지적 실수를 묻는 설문(CFQ)에서는 집단 차이가 없었습니다. 단일영역 훈련과 직접 비교한 연구가 아니었습니다.
더 큰 문제는 같은 과장이 스킬, 기획서(GDD), 제출 요약서 세 곳에 모두 있었다는 점입니다. 저장소에는 이 순서대로 기록돼 있습니다. 다만 커밋 순서만으로 실제로 어디서 어디로 옮겨 적혔는지까지 확정할 수는 없습니다. 지침은 반복해서 쓰라고 만드는 문서입니다. 확인하지 않은 문장이 지침에 들어가면 이후 작업에서 계속 근거로 쓰입니다. 새 컨텍스트의 리뷰어도 같은 지침을 받으면, 그 근거를 따로 확인하지 않는 한 같은 오류를 받아들일 수 있습니다.
대조하면서 두 가지가 더 나왔습니다. - 제출 요약서는 다른 논문(PMC4616083)을 “태블릿 선례”로 소개했지만 원문은 치매 환자 대상 연구로 태블릿 언급이 없었습니다. - 제출 요약서에는 “22sp 이상 글자, 단일 탭만”이라고 적었지만 실제 앱의 선택 라벨은 20sp였고 목록 스크롤도 있었습니다. 연구의 22pt와 앱의 sp를 어떻게 대응시킬지 정하지 않은 문제도 있었습니다. 하지만 그보다 먼저 제출 문서와 구현을 대조하는 검증이 빠져 있었습니다.
맞는 근거도 있었습니다. 글자 22pt 기준의 출처(Yeh, 2020)는 원문에서도 22pt일 때 고령자의 수행이 청년과 비슷했습니다. 다만 태블릿에 띄운 혈압계 조작 화면으로 진행한 과제의 결과라서, 앱의 최소 글자 크기를 확정해 주는 연구는 아닙니다.
블로그 글을 쓰면서 세 문서의 잘못된 서술을 원문과 구현에 맞게 정정했습니다. 정정 후 교차 리뷰에서 기획 스킬의 템플릿 안내문에 같은 뜻을 암시하는 문장이 한 곳 더 남아 있어서 그것도 고쳤습니다. 기획 스킬에는 규칙을 하나 추가했습니다. “근거 링크를 달 때는 원문에서 직접 확인한 문장(대상, 비교군, 결과)을 함께 적는다.” 이미 제출한 PDF는 바뀌지 않으므로, 정정 사실은 이 글로 남깁니다.
6. 다음 검증 기준
- 지침의 효과를 비교로 확인한다. Claude Code 공식 문서는 스킬을 쓸 때 실제 요청을 새 세션에서 스킬이 있을 때와 없을 때로 돌려 비교하라고 권합니다. 이번에는 이 비교를 하지 않아서 스킬이 품질에 얼마나 기여했는지 말할 수 없습니다. 다음에는 같은 코드, 같은 모델, 같은 검토 요청을 고정한 채 지침이 있을 때와 없을 때를 여러 새 세션에서 돌려, 유효한 지적과 잘못된 지적의 수를 비교하겠습니다. 공식 문서가 따로 재라고 권하는 것처럼, 스킬이 불려야 할 요청에서 실제로 불리는지도 함께 확인하고 검토 시간과 토큰 사용량도 기록하겠습니다.
- 강제해야 할 것은 테스트로 옮긴다. 지침은 AI가 읽고 따르는 권고입니다. 48dp, 글자 크기, “10개 품목 모두 선택 가능” 같은 기준은 한 파일에 정의하고, UI 테스트로 고정해 어기면 검증 명령이 실패하게 만들겠습니다. 반대로 코드에서 바로 확인할 수 있거나 중복된 지침은 지운 뒤 그 전후의 검토 결과를 비교하겠습니다.
- 근거는 원문 확인 문장과 함께 적는다. 위에서 지침에 추가한 규칙입니다.
- 실제 기기에서 확인한다. 이번 검증은 에뮬레이터 기준이었고 실제 태블릿과 시니어 사용자 확인은 하지 못했습니다.
- 사람이 결정하는 지점은 줄이지 않는다. “이 서사가 시니어를 존중하는가”는 체크리스트가 상기시켜 줄 수는 있어도 판단해 주지는 못했습니다.
이번 작업에서 저는 코드 작성보다 규정을 해석해 맞는 동작을 정하고 그것을 확인할 방법을 적어 두는 일에 더 많은 시간을 썼습니다. 그리고 그렇게 적어 둔 지침도 원문과 구현에 다시 대조해야 한다는 것을 이번에 배웠습니다.
참고 자료
- Gajewski, P. D., Thönes, S., Falkenstein, M., Wascher, E., & Getzmann, S. (2020). Multidomain cognitive training transfers to attentional and executive functions in healthy older adults. Frontiers in Human Neuroscience, 14, 586963. https://doi.org/10.3389/fnhum.2020.586963
- Yeh, P.-C. (2020). Impact of button position and touchscreen font size on healthcare device operation by older adults. Heliyon, 6(6), e04147. https://doi.org/10.1016/j.heliyon.2020.e04147
- Jang, J. S., Lee, J. S., & Yoo, D. H. (2015). Effects of spaced retrieval training with errorless learning in the rehabilitation of patients with dementia. Journal of Physical Therapy Science, 27(9), 2735–2738. https://doi.org/10.1589/jpts.27.2735
- Anthropic. Extend Claude with skills. Claude Code Docs. https://code.claude.com/docs/en/skills
- ㈜에이아이씨유. 「시니어 인지기능 향상 게임 개발 해커톤」 기획안 9장, 11장, 12.1, 13.1, 14장, 15.5 (참가팀 배포 자료).
코드와 관련 글
- 앱 소스 코드: kms7625/senior_app_2
- 결함 2개를 고친 커밋: a681701 — fresh-context 코드 리뷰 발견사항 수정
- 첫 번째 이야기: 테스트는 통과했는데, 6개의 물건은 고를 수 없었다 — 시니어 인지 게임 개발기