DICOM 비식별화, 파이썬으로 정말 지워질까? 가짜 환자 정보를 심어 5가지 방법을 검사했다
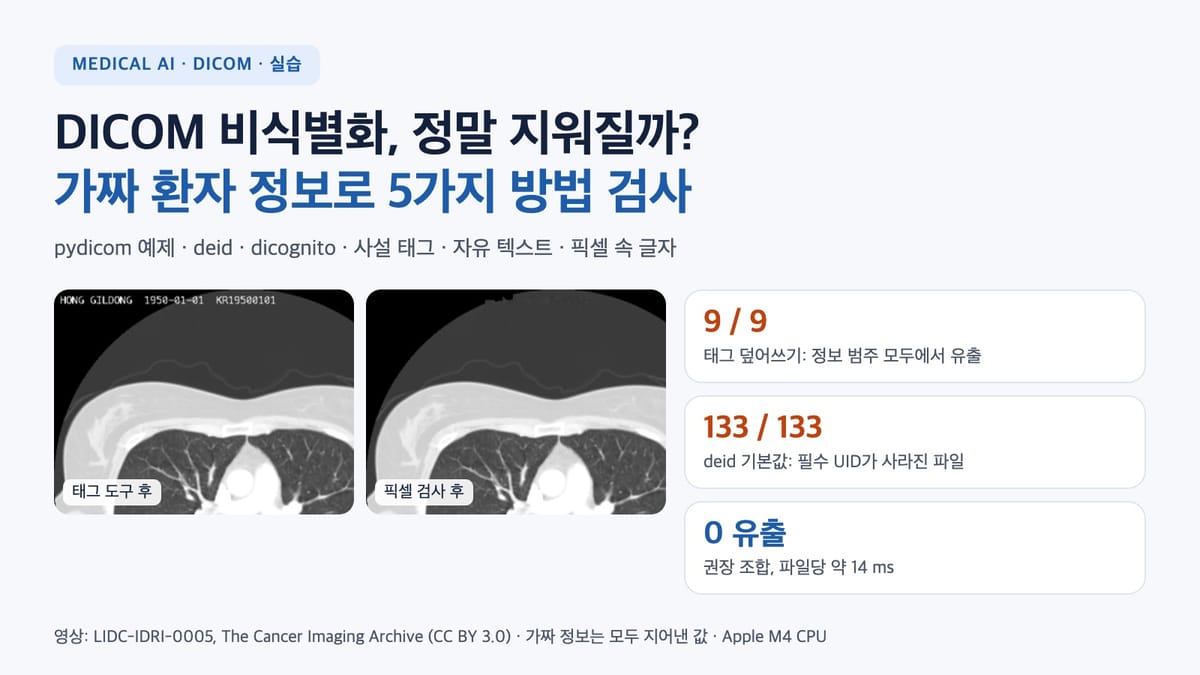
DICOM 익명화, 태그 몇 개 덮어쓰면 끝일까? 공개 CT에 가짜 정보를 심어 5가지 방법을 시험했다. 덮어쓰기는 9개 범주 모두 유출, deid 기본값은 UID를 전부 삭제, 픽셀 속 글자는 태그 도구 4개 모두 그대로였다.
CT를 외부 연구팀이나 클라우드 학습 서버로 보내기 전에 반드시 거치는 단계가 DICOM 비식별화(익명화)다. 검색해 보면 파이썬 예제는 많다. 대부분 pydicom으로 PatientName, PatientID, 생년월일 몇 개를 덮어쓰고 끝난다. 그런데 그렇게 만든 파일에 정말 개인정보가 남지 않는지 확인한 글은 찾기 어렵다.
그래서 직접 시험했다. 이미 비식별된 공개 CT에 가짜 환자 정보(홍길동, 가짜 전화번호·주소·병원명, 사설 태그, 픽셀에 구운 글자)를 심고, 흔히 쓰는 다섯 가지 방법으로 비식별화한 뒤 133개 파일 전체를 다시 뒤져 무엇이 남았는지 셌다. 이 글의 숫자는 모두 아래 코드를 직접 돌려 얻은 값이다. 환경: Apple M4, 16 GB RAM, macOS 26.6.2, Python 3.12, CPU만 사용.
요약하면 이렇다.
- 태그 몇 개만 덮어쓰는 방식은 검사한 정보 범주 9개 모두에서 정보가 남았다. 의뢰 의사 이름, 주소·전화번호, 원본 UID 8종, 사설 태그, 픽셀 속 글자가 그대로였다.
- 잘 알려진 도구도 기본값만으로는 부족했다. dicognito는 이름·ID·날짜·UID를 일관되게 바꿨지만 사설 태그와 자유 텍스트(
StudyDescription,ImageComments)에 이름이 남았다. deid 기본 레시피는 UID를 전부 지워서 133개 파일 모두 필수 UID가 없는 파일이 됐다. - 태그를 다루는 도구는 픽셀 속 글자를 하나도 지우지 못했다. 네 방법 모두 구운 글자 픽셀 108,528개가 그대로 남았다.
- 권장 조합(자유 텍스트 삭제 + 사설 태그 삭제 + dicognito + 픽셀 글자 가리기)은 심은 정보를 모두 지웠고, 3D 볼륨과 HU 값도 유지됐다. 파일당 약 14 ms였다.
먼저 짚어 둘 것이 있다. 이 글은 기술적 점검 방법을 다룬다. 실제 환자 데이터를 반출할 때는 개인정보보호법의 가명처리 규정, 기관 IRB, 보건복지부의 보건의료 데이터 활용 가이드라인 같은 절차를 따라야 한다. 코드는 그 절차를 대신하지 않는다.
1. 시험용 데이터: 공개 CT에 가짜 정보 심기
지난 실습처럼 TCIA의 LIDC-IDRI 컬렉션을 쓴다. 환자 0005의 CT series 1개(133장, 512×512, 슬라이스 간격 2.5 mm)를 받았다. LIDC-IDRI는 TCIA가 이미 비식별화해서 공개한 데이터라서 이름 칸이 비어 있다. 그래서 시험을 위해 지어낸 값을 넣는다. 실제 사람의 정보는 하나도 쓰지 않았다.
mkdir -p data/0005 && cd data
curl -s -o 0005.zip \
  "https://services.cancerimagingarchive.net/nbia-api/services/v1/getImage?SeriesInstanceUID=1.3.6.1.4.1.14519.5.2.1.6279.6001.129007566048223160327836686225"
unzip -q 0005.zip -d 0005 && rm 0005.zip && cd ..

pip install pydicom SimpleITK numpy scipy pillow matplotlib dicognito deid
LIDC-IDRI는 CC BY 3.0 라이선스이므로 쓸 때 데이터셋과 논문을 인용해야 한다(글 끝 참고문헌). TCIA 이용 조건에 따라 데이터로 참여자를 식별하려 해서는 안 된다.
심은 값은 병원 데이터에서 실제로 개인정보가 숨어 있는 자리를 골랐다. plant_phi.py의 핵심:
FAKE = {
    "PatientName": "HONG^GILDONG",
    "PatientID": "KR19500101",
    "PatientBirthDate": "19500101",
    "PatientAddress": "123 TEHERAN-RO GANGNAM-GU SEOUL",
    "PatientTelephoneNumbers": "010-1234-5678",
    "OtherPatientIDs": "INS-77889900",
    "InstitutionName": "VIRTUAL GENERAL HOSPITAL",
    "InstitutionAddress": "45 SEJONG-DAERO JUNG-GU SEOUL",
    "ReferringPhysicianName": "KIM^CHEOLSU",
    "OperatorsName": "LEE^YOUNGHEE",
    "StationName": "VGH-CT01",
    "AccessionNumber": "ACC20240517",
    "StudyID": "S20240517",
    "StudyDescription": "CT CHEST HONG GILDONG F/U",               # 자유 텍스트
    "ImageComments": "pt HONG^GILDONG 010-1234-5678 lung nodule f/u",
}


def plant(ds):
    for kw, value in FAKE.items():
        setattr(ds, kw, value)
    for kw in ("StudyDate", "SeriesDate", "AcquisitionDate", "ContentDate"):
        setattr(ds, kw, "20240517")
    # 시퀀스 안에 숨은 이름
    item = Dataset()
    item.RequestingPhysician = "PARK^MINSU"
    item.RequestedProcedureDescription = "CT CHEST for HONG GILDONG"
    ds.RequestAttributesSequence = Sequence([item])
    # 사설(private) 태그: 장비·병원 시스템이 자유롭게 쓰는 영역
    block = ds.private_block(0x0011, "ACME HIS 1.0", create=True)
    block.add_new(0x01, "LO", "HONG^GILDONG|KR19500101")
여기에 더해 모든 슬라이스의 왼쪽 위(몸 밖 공기 영역)에 HONG GILDONG 1950-01-01 KR19500101이라는 글자를 3000 HU 값으로 구워 넣었다. 오래된 장비의 화면 캡처, 초음파, 스캔한 문서에서 흔한 형태다. 이때 BurnedInAnnotation은 일부러 NO로 둔다. 현실에서도 이 플래그가 틀린 경우가 있다.
2. 비교한 다섯 가지 방법
- 태그 몇 개만 덮어쓰기. 블로그 예제에서 가장 흔한 형태. 이름·ID·검사 번호를
ANONYMIZED로, 생년월일과 날짜 3개를19000101로 바꾼다. - pydicom 공식 예제. 문서의 예제 그대로. VR이 PN인 값(사람 이름)을 모두
anonymous로 바꾸고, curve와 사설 태그를 지우고, ID와 생년월일을 바꾼다. 문서도 "시작점"이라고 소개한다. - deid 기본 레시피. pydicom/deid의
replace_identifiers()를 레시피 없이 호출했다. - dicognito 기본값. dicognito의
Anonymizer. 이름·ID·주소를 그럴듯한 가짜 값으로 바꾸고, 날짜는 한 덩어리로 같은 만큼 옮기고, UID는 일관되게 새로 만든다. - 권장 조합. 자유 텍스트 태그 삭제 → 사설 태그 삭제 → dicognito → 픽셀 글자 가리기.
2번과 5번의 코드는 이렇다(deid_methods.py).
import pydicom
from dicognito.anonymizer import Anonymizer


def pydicom_example(ds):  # pydicom 문서 예제
    def person_names_callback(ds, elem):
        if elem.VR == "PN":
            elem.value = "anonymous"

    def curves_callback(ds, elem):
        if elem.tag.group & 0xFF00 == 0x5000:
            del ds[elem.tag]

    ds.PatientID = "id"
    ds.walk(person_names_callback)
    ds.walk(curves_callback)
    ds.remove_private_tags()
    if "OtherPatientIDs" in ds:
        delattr(ds, "OtherPatientIDs")
    if "PatientBirthDate" in ds:
        ds.data_element("PatientBirthDate").value = "19000101"


FREE_TEXT = [  # PS3.15 Basic Profile에서 X(삭제)인 서술형 항목 일부
    "StudyDescription", "SeriesDescription", "ImageComments", "RequestAttributesSequence",
    "AdditionalPatientHistory", "PatientComments", "StudyComments", "ProtocolName",
    "PerformedProcedureStepDescription", "DerivationDescription",
]


def recommended_factory():
    anon = Anonymizer()  # 시리즈 전체에 같은 객체를 써야 UID·날짜 매핑이 유지된다

    def recommended(ds):
        for kw in FREE_TEXT:
            if kw in ds:
                delattr(ds, kw)
        ds.remove_private_tags()
        anon.anonymize(ds)
        mask_burned_in(ds)          # 아래 4절
        ds.BurnedInAnnotation = "NO"  # 가린 뒤에만 NO
    return recommended


rec = recommended_factory()
for f in sorted(Path("data/planted").glob("*.dcm")):
    ds = pydicom.dcmread(f)
    rec(ds)
    ds.save_as(out / f.name)
주의할 점이 하나 있다. Anonymizer()를 파일마다 새로 만들면 파일마다 다른 UID와 날짜 이동값이 나와서 한 시리즈가 133개의 시리즈로 흩어진다. 시리즈(또는 환자) 단위로 하나를 재사용해야 한다. 같은 환자를 나중에 추가로 받을 예정이면 Anonymizer(seed="...")로 시드를 고정하고, 그 시드는 키처럼 따로 보관한다.
3. 검사 방법: 133개 파일을 다시 뒤진다
비식별화 결과를 눈으로 몇 장 보는 것으로는 부족하다. evaluate.py는 출력 파일마다 시퀀스 안과 사설 태그까지 모든 값을 문자열로 꺼내서 심어 둔 값(카나리아)이 있는지 찾는다. 원본 UID가 남았는지, 필수 UID(Study/Series/SOP Instance UID)가 있는지, SimpleITK로 여전히 한 개의 3D 볼륨으로 읽히는지, HU 값이 바뀌지 않았는지도 확인한다.
CANARIES = {
    "name": ["GILDONG", "CHEOLSU", "YOUNGHEE", "MINSU"],
    "patient_id": ["KR19500101", "INS-77889900"],
    "address_phone": ["TEHERAN", "SEJONG-DAERO", "010-1234-5678"],
    "institution": ["VIRTUAL GENERAL", "VGH-CT01"],
    "exam_date": ["20240517"],
    # ...
}


def strings(ds):
    """사설 태그와 시퀀스 안까지 모든 값을 (태그 이름, 문자열)로 꺼낸다."""
    out = []
    for elem in ds.iterall():          # iterall()은 시퀀스 안으로 들어간다
        if elem.tag == (0x7FE0, 0x0010) or elem.VR == "SQ":
            continue
        out.append((elem.keyword or str(elem.tag), str(elem.value)))
    for elem in ds.file_meta:          # 파일 메타(0002 그룹)도 본다
        out.append((elem.keyword, str(elem.value)))
    return out
처음에는 성 HONG도 카나리아에 넣었다. 그랬더니 권장 조합에서 "이름 유출"이 잡혔다. 확인해 보니 dicognito가 무작위로 만든 가짜 병원 주소가 ... HONG KONG ...이었다. 흔한 성은 오탐을 낸다. 그래서 이름 카나리아는 GILDONG처럼 드문 문자열만 남겼다. 자기 데이터로 검사할 때도 같은 일이 생기니 참고하자.
4. 결과: 무엇이 남았나
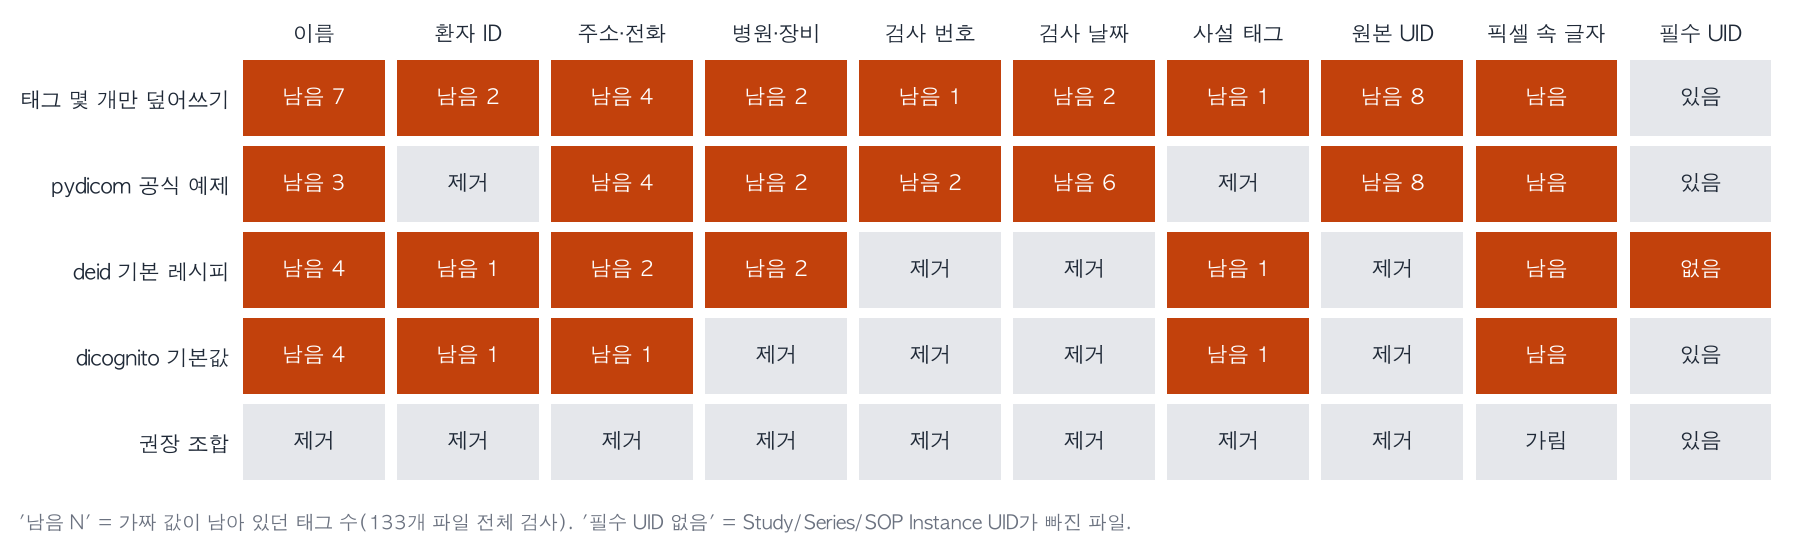
방법별로 남은 곳을 정리하면 다음과 같다.
| 방법 | 남은 개인정보 (태그) | 그 밖의 문제 |
|---|---|---|
| 태그 몇 개만 덮어쓰기 | 의뢰 의사·촬영자 이름, 주소·전화, OtherPatientIDs, 병원명·장비명, StudyID, AcquisitionDate, 자유 텍스트 3곳, 사설 태그 | 원본 UID 8종이 그대로 → 공개 데이터와 다시 연결 가능 |
| pydicom 공식 예제 | 주소·전화, 병원명·장비명, 검사 번호, 검사 날짜 4종, 자유 텍스트 3곳 | 원본 UID 8종 그대로 |
| deid 기본 레시피 | 병원명·주소·장비명, 자유 텍스트 3곳, 사설 태그 | UID를 모두 삭제 → 133개 파일 전부 필수 UID 없음 |
| dicognito 기본값 | 자유 텍스트 3곳(StudyDescription, ImageComments, 시퀀스 안 RequestedProcedureDescription), 사설 태그 | 없음 |
| 권장 조합 | 없음 | 없음 |
방법마다 짚어 볼 점:
- 이름은
PatientName에만 있지 않다. 덮어쓰기 방식은ReferringPhysicianName,OperatorsName, 시퀀스 안의RequestingPhysician을 놓쳤다. pydicom 예제처럼 VR이 PN인 값을 전부 바꾸면 이 문제는 해결된다. - 날짜는 ID 안에도 있다. 우리가 넣은
AccessionNumber(ACC20240517)와StudyID(S20240517)에는 검사 날짜가 들어 있다. 병원 시스템에서 흔한 형식이다. 날짜 태그만 바꾸면 ID에서 날짜가 그대로 보인다. - UID도 식별 정보다. 덮어쓰기와 pydicom 예제는 UID를 건드리지 않았다. 원본 Study/Series/SOP Instance UID가 남으면 원본 PACS나 이미 공개된 데이터와 1:1로 다시 연결된다.
- deid 기본 레시피는 반대로 너무 많이 지운다. 레시피에
REMOVE contains:UID규칙이 있어 Study/Series/SOP Instance UID와 파일 메타의MediaStorageSOPInstanceUID까지 모두 사라졌다. SimpleITK는 이 파일을 읽었지만, PACS나 뷰어에 올리면 거부될 수 있는 비표준 파일이다. deid는 레시피를 직접 쓰는 것을 전제로 한 프레임워크이므로, 기본값 그대로 쓰지 말고 UID를 새 값으로 바꾸는 규칙을 넣어야 한다. - dicognito는 가장 좋은 출발점이었다. 이름·ID·주소·병원명을 모두 가짜 값으로 바꾸고, UID를 일관되게 새로 만들어 133장이 그대로 한 시리즈로 읽혔다. 날짜는 모두 같은 만큼 옮겨서(이번 실행에서는 2024-05-17 → 2022-12-06, 생년월일도 같은 만큼) 검사 간 간격이 유지된다. 다만 기본값으로는 자유 텍스트와 사설 태그를 그대로 두었다.
픽셀 속 글자는 아무도 지우지 않는다
태그를 다루는 네 방법 모두 픽셀 데이터는 건드리지 않았다. 구운 글자 픽셀 108,528개(133장 합계)가 네 방법 모두에서 그대로 남았다. 이것은 버그가 아니라 설계다. 태그 도구는 태그만 본다. 그래서 권장 조합에는 간단한 픽셀 검사를 넣었다.
import numpy as np
from scipy import ndimage


def mask_burned_in(ds, min_hu=1500, air_hu=-900, pad=3):
    """몸 밖 공기 영역에 있는 아주 밝은 덩어리(글자)를 찾아 주변 값으로 덮는다."""
    arr = ds.pixel_array
    hu = arr * float(ds.RescaleSlope) + float(ds.RescaleIntercept)
    # 영상 가장자리와 이어진 공기 = 몸 밖
    lab, _ = ndimage.label(hu < air_hu)
    edge = np.unique(np.concatenate([lab[0], lab[-1], lab[:, 0], lab[:, -1]]))
    near_outside = ndimage.binary_dilation(np.isin(lab, edge[edge > 0]), iterations=pad)
    bright = hu > min_hu
    lab_b, _ = ndimage.label(bright)
    text = np.zeros_like(bright)
    h, w = bright.shape
    for i, (ys, xs) in enumerate(ndimage.find_objects(lab_b), start=1):
        sl = (slice(max(ys.start - 3, 0), min(ys.stop + 3, h)),
              slice(max(xs.start - 3, 0), min(xs.stop + 3, w)))
        comp = lab_b[sl] == i
        ring = ndimage.binary_dilation(comp, iterations=2) & ~bright[sl]
        if ring.any() and near_outside[sl][ring].mean() > 0.8:  # 둘레가 대부분 몸 밖 공기
            text[sl] |= comp
    if not text.any():
        return 0
    text = ndimage.binary_dilation(text, iterations=pad)
    # 가린 픽셀마다 가장 가까운 '글자 아닌' 픽셀 값을 복사한다
    _, (iy, ix) = ndimage.distance_transform_edt(text, return_indices=True)
    ds.PixelData = arr[iy, ix].astype(arr.dtype).tobytes()
    return int(text.sum())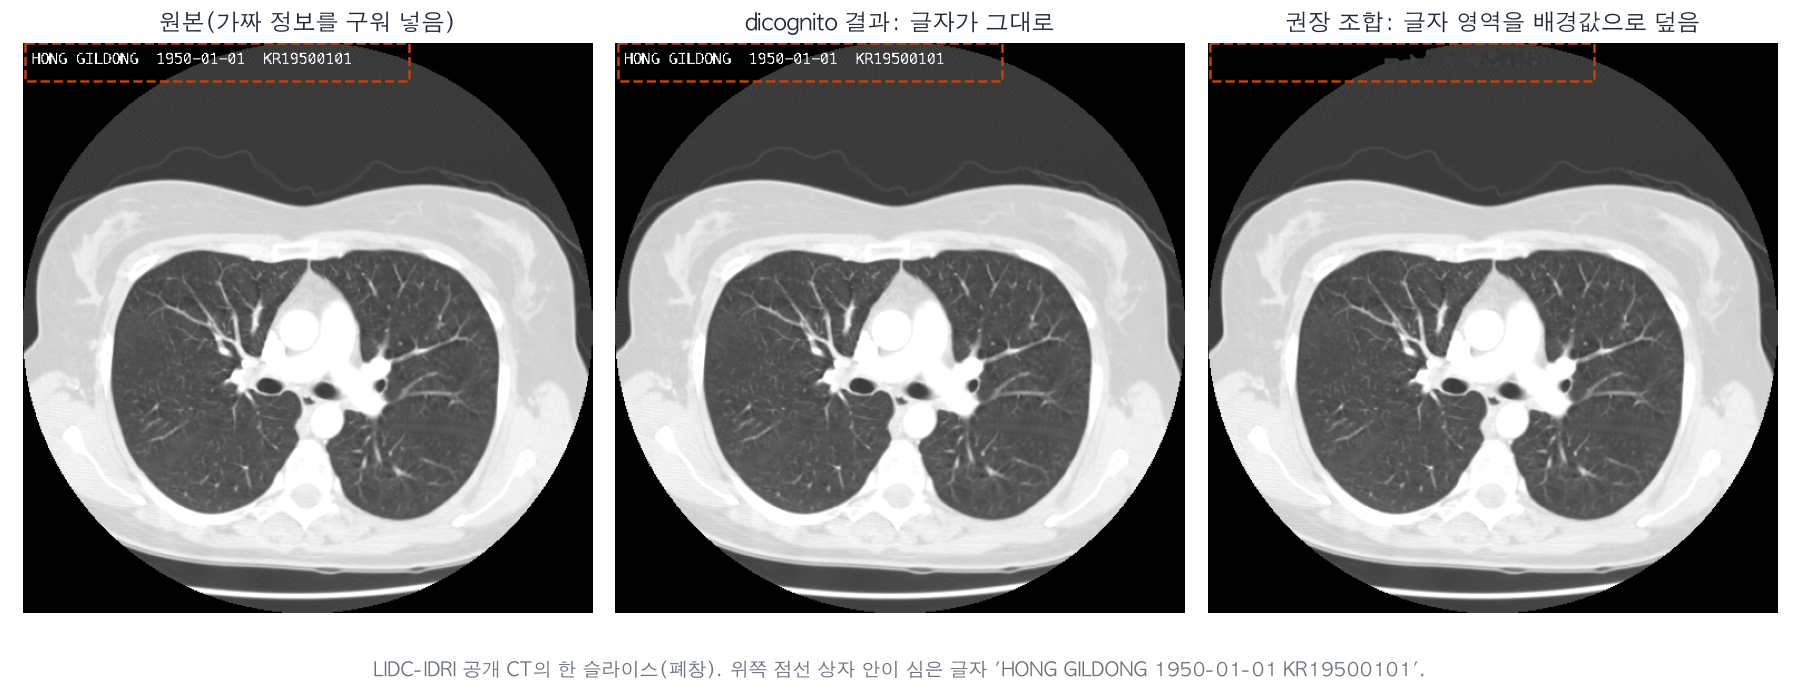
처음 버전은 가린 자리를 주변 픽셀의 중앙값 하나로 채웠다. 그런데 글자가 FOV 원 경계(−2048 HU 영역과 공기 −1000 HU 영역의 경계)에 걸쳐 있어서, 채운 자리가 주변보다 어둡거나 밝게 보였고 KR19500101의 윤곽이 희미하게 읽혔다. "가렸다"는 것과 "읽을 수 없다"는 것은 다르다. 가장 가까운 픽셀 값을 복사하도록 바꾼 뒤에는 글자 모양이 남지 않았고, 3000 HU 이상 글자 픽셀도 0개가 됐다.
이 탐지기를 글자가 없는 깨끗한 CT 3건(LIDC-IDRI 0001, 0003, 0005, 총 406장)에 돌려 오탐도 셌다.
- 0001: 133장 중 0장
- 0003: 140장 중 6장, 197픽셀
- 0005: 133장 중 1장, 25픽셀
오탐 7건은 모두 영상 오른쪽 끝, 몸 밖에 있는 1500–2450 HU의 작은 점(장당 25–46픽셀)이었다. 몸 안 픽셀은 한 번도 바뀌지 않았다. 그래도 이것은 "몸 밖의 밝은 점"을 찾는 단순한 규칙일 뿐이다. 글자가 몸 위에 겹친 경우, 초음파처럼 배경이 공기가 아닌 영상, 어두운 글자는 잡지 못한다. 실제로는 이 검사로 의심 슬라이스를 골라 사람이 확인하고, 필요하면 OCR이나 장비별 고정 영역 가리기를 더해야 한다. deid의 픽셀 필터 레시피가 장비 모델별 좌표를 모아 둔 것도 그래서다.
데이터는 여전히 쓸 수 있나
비식별화가 데이터를 망가뜨리면 소용없다. 다섯 방법 모두 SimpleITK로 읽었을 때 133×512×512 볼륨 하나로 읽혔고, 복셀 간격도 같았다. HU 값은 글자를 심은 상자 밖에서 네 방법 모두 원본과 같았다. 권장 조합만 상자 밖에서 달라진 픽셀이 있었는데, 앞에서 본 0005의 오탐 25픽셀이다.
속도(133개 파일 읽기+처리+저장, 3회 실행, 파일당):
| 방법 | ms/파일 |
|---|---|
| 태그 몇 개만 덮어쓰기 | 0.8–1.7 |
| pydicom 공식 예제 | 1.4–1.5 |
| dicognito 기본값 | 1.9–2.3 |
| deid 기본 레시피 | 6.5–7.3 |
| 권장 조합 (픽셀 검사 포함) | 14.3–14.7 |
픽셀 검사를 넣어도 CT 한 건(133장)에 약 2초다. 속도는 고를 이유가 되지 않는다.
체크리스트
- 이름은 VR이 PN인 값 전부, 시퀀스 안까지 바꾼다.
- UID는 지우지 말고 일관되게 새로 만든다. 한 시리즈·한 환자에는 같은 매핑을 쓴다.
- 날짜는 지우거나 같은 만큼 옮긴다.
AccessionNumber,StudyID같은 ID 안의 날짜도 확인한다. - 사설 태그는 기본적으로 지운다. 꼭 필요한 사설 태그만 확인 후 남긴다.
- 자유 텍스트(
StudyDescription,ImageComments, 의뢰 정보 시퀀스)는 지우거나 사람이 확인한다. BurnedInAnnotation플래그를 믿지 말고 픽셀을 검사한다.- 마지막으로 출력 파일 전체를 다시 검사한다. 자기 기관의 실제 형식(ID 규칙, 사설 태그 이름)으로 카나리아를 만들어 넣고 돌려 보는 것이 가장 확실하다.
검사 스크립트
"""usage: python evaluate.py PLANTED_DIR OUT_ROOT RESULT_JSON   (OUT_ROOT/<method>/*.dcm)"""
import json, sys
from pathlib import Path

import numpy as np
import pydicom
import SimpleITK as sitk

REQUIRED_UIDS = ["StudyInstanceUID", "SeriesInstanceUID", "SOPInstanceUID"]


def check_tags(folder, orig_uids):
    hits = {k: set() for k in CANARIES}
    uid_hits, missing = set(), 0
    for f in sorted(folder.glob("*.dcm")):
        ds = pydicom.dcmread(f)
        if any(not ds.get(kw) for kw in REQUIRED_UIDS) or "MediaStorageSOPInstanceUID" not in ds.file_meta:
            missing += 1
        for kw, val in strings(ds):
            for cat, words in CANARIES.items():
                if any(w.upper() in val.upper() for w in words):
                    hits[cat].add(kw)
            if val in orig_uids:
                uid_hits.add(kw)
    res = {cat: sorted(v) for cat, v in hits.items()}
    res["original_uid"] = sorted(uid_hits)
    res["files_missing_required_uids"] = missing
    return res


def read_volume(folder):
    reader = sitk.ImageSeriesReader()
    series = reader.GetGDCMSeriesIDs(str(folder))
    reader.SetFileNames(reader.GetGDCMSeriesFileNames(str(folder), series[0]))
    img = reader.Execute()
    return series, sitk.GetArrayFromImage(img), img.GetSpacing()
글에 싣기 위해 줄였다. 실제로 돌린 전체 코드(plant_phi.py, deid_methods.py, evaluate.py, mask_false_positive.py, figures.py)와 결과 JSON을 함께 정리해 두었다. 사용한 버전: pydicom 3.0.2, dicognito 0.19.0, deid 0.4.13, SimpleITK 2.5.7, NumPy 2.5.4, SciPy 1.18.1.
참고문헌
- DICOM PS3.15, Annex E: Attribute Confidentiality Profiles (Basic Application Level Confidentiality Profile).
- pydicom: Anonymize DICOM data 예제.
- dicognito (MIT), pydicom/deid (MIT).
- S. G. Armato III et al. The Lung Image Database Consortium (LIDC) and Image Database Resource Initiative (IDRI): a completed reference database of lung nodules on CT scans. Medical Physics 38(2), 915–931, 2011. doi:10.1118/1.3528204
- LIDC-IDRI 데이터셋, The Cancer Imaging Archive. doi:10.7937/K9/TCIA.2015.LO9QL9SX (CC BY 3.0)
- K. Clark et al. The Cancer Imaging Archive (TCIA): maintaining and operating a public information repository. Journal of Digital Imaging 26(6), 1045–1057, 2013. doi:10.1007/s10278-013-9622-7